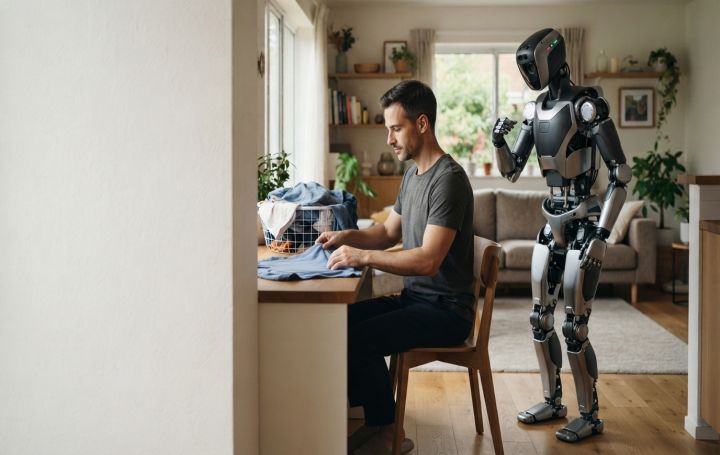
Figure بیش از ۱۶ میلیون ویدئوی انسانی جمع کرده است؛ رباتهای انساننما چگونه از انسانها یاد میگیرند؟
فهرست مطالب
Figure چرا میلیونها ویدئوی انسانی جمعآوری میکند؟
یکی از بزرگترین چالشهای توسعه رباتهای انساننما، مسئلهای است که در نگاه اول ساده به نظر میرسد: ربات از کجا باید یاد بگیرد؟
یک انسان از کودکی دائماً در حال یادگیری از محیط اطراف خود است. انسان میبیند، لمس میکند، حرکت میکند، اشتباه میکند و دوباره تلاش میکند. همین تجربه مداوم باعث میشود انجام بسیاری از فعالیتهای روزمره برای انسان کاملاً طبیعی به نظر برسد.
برای مثال، برداشتن یک لیوان از روی میز برای یک انسان کار پیچیدهای نیست. اما اگر بخواهیم همین کار را به یک ربات یاد بدهیم، مسئله بسیار پیچیدهتر میشود.
ربات باید بتواند لیوان را تشخیص دهد، موقعیت آن را نسبت به بدن خود محاسبه کند، دستش را به سمت آن حرکت دهد، میزان مناسب نیرو را اعمال کند، لیوان را بدون افتادن بردارد و سپس آن را در مقصد قرار دهد.
حالا همین مسئله را برای صدها یا هزاران فعالیت مختلف در نظر بگیرید.
باز کردن در، جمعکردن لباس، مرتبکردن اتاق، برداشتن ظرف، جابهجایی یک جعبه، کار با ابزار، حرکت در یک محیط شلوغ و حتی تعامل با انسانها، همگی به تجربه نیاز دارند.
شرکت Figure معتقد است یکی از راههای عبور از این مشکل، جمعآوری حجم بسیار بزرگی از دادههای مربوط به رفتار واقعی انسانهاست.
به همین دلیل این شرکت پروژهای با نام Index راهاندازی کرده است؛ پروژهای که هدف آن ایجاد یک مجموعه داده بزرگ و متنوع برای آموزش رباتهای انساننما و مدل هوش مصنوعی Helix است.
Figure در معرفی رسمی Index اعلام کرده بود که این پروژه بیش از ۱۶ میلیون ویدئو از فعالیتهای انسانی جمعآوری کرده و دادهها از ۱۰۸ کشور دریافت شدهاند.
[تصویر ۱ – کاور مقاله]
پیشنهاد تصویر: یک تصویر واقعگرایانه و سینمایی از یک ربات انساننما در محیط واقعی خانه که در حال مشاهده و یادگیری از فعالیت یک انسان است؛ در پسزمینه نشانههایی از جمعآوری داده و ویدئو دیده شود، اما هیچ متن، لوگو یا نوشتهای در تصویر نباشد.
پروژه Index چیست؟
Index را میتوان یکی از مهمترین بخشهای استراتژی Figure برای حل «مشکل داده» در رباتیک دانست.
مدلهای هوش مصنوعی مختلف میتوانند از حجم بسیار زیادی از اطلاعات موجود در اینترنت یاد بگیرند. متن، تصویر، ویدئو و سایر دادههای دیجیتال در مقیاس بسیار وسیعی در دسترس هستند.
اما رباتهای انساننما با یک مشکل متفاوت مواجهاند.
آنها باید دنیای فیزیکی را یاد بگیرند.
این یعنی فقط دانستن اینکه «لیوان چیست» کافی نیست. ربات باید بداند لیوان چگونه روی میز قرار میگیرد، چگونه باید آن را گرفت، اگر لیوان خیس باشد چه تغییری در حرکت لازم است و اگر فرد دیگری جلوی ربات قرار گرفت چگونه باید مسیر خود را تغییر دهد.
Figure در توضیح پروژه Index میگوید داده موردنیاز برای ساخت رباتهای عمومی را نمیتوان صرفاً از اینترنت به دست آورد؛ این داده باید از دنیای واقعی و از تعامل انسانها با محیط جمعآوری شود.
در این پروژه، افراد با استفاده از اپلیکیشن Index فعالیتهای مختلف خود را ثبت میکنند و دادههای بهدستآمده پس از پردازش برای آموزش سیستمهای هوش مصنوعی Figure مورد استفاده قرار میگیرند.
بر اساس اطلاعات منتشرشده توسط Figure، این پروژه در زمان معرفی بیش از ۲۶۴ هزار دانلود اپلیکیشن و بیش از ۱۶ میلیون ویدئوی آپلودشده داشت و دادهها از ۱۰۸ کشور جمعآوری شده بودند. Figure همچنین اعلام کرده حدود ۱۵ میلیون دلار به مشارکتکنندگان داده پرداخت کرده است.
۱۶ میلیون ویدئو دقیقاً چه چیزی به رباتها یاد میدهد؟

شاید در نگاه اول تصور کنیم Figure فقط به دنبال جمعآوری تعداد زیادی ویدئو است؛ اما ارزش اصلی Index صرفاً در تعداد ویدئوها خلاصه نمیشود.
تنوع دادهها اهمیت بسیار زیادی دارد.
فرض کنید رباتی فقط در یک خانه آموزش دیده باشد. در این شرایط، ممکن است بتواند یک اتاق مشخص، یک میز مشخص و حتی اشیای مشخصی را بهخوبی مدیریت کند.
اما اگر وارد خانه دیگری شود چه اتفاقی میافتد؟
میز ممکن است ارتفاع متفاوتی داشته باشد. مبل شکل دیگری داشته باشد. لباسها روی زمین باشند. نور محیط متفاوت باشد یا وسایل در جای دیگری قرار گرفته باشند.
انسان معمولاً میتواند با چنین تغییراتی کنار بیاید، زیرا در طول زندگی خود با هزاران محیط متفاوت مواجه شده است.
Figure تلاش میکند با جمعآوری داده از افراد و محیطهای مختلف، بخشی از همین تنوع را وارد فرآیند آموزش ربات کند.
به همین دلیل Index شامل فعالیتهایی از محیطهای مختلف است؛ از خانه و فعالیتهای روزمره گرفته تا محیطهای کاری، رستورانها، کارخانهها و مراکز لجستیکی.
دادههای متنوع چه کمکی به ربات میکنند؟
| نوع محیط | نمونه فعالیت | مهارتی که ربات میتواند یاد بگیرد |
|---|---|---|
| خانه | مرتبکردن لباس | دستکاری اشیای انعطافپذیر |
| آشپزخانه | جابهجایی ظروف | تشخیص و گرفتن اشیا |
| اتاق | مرتبکردن وسایل | درک فضای اطراف |
| رستوران | جابهجایی ظروف | فعالیت در محیط پویا |
| کارخانه | جابهجایی تجهیزات | تعامل با محیط صنعتی |
| انبار | جابهجایی بستهها | انجام وظایف لجستیکی |
| دفتر | تعامل با اشیای مختلف | فعالیت در محیط انسانی |
بنابراین هدف Figure این نیست که ربات فقط یک کار مشخص را یاد بگیرد؛ بلکه هدف، ایجاد پایهای برای یادگیری عمومیتر رفتارهای فیزیکی است.
چرا رباتها به دادههای دنیای واقعی نیاز دارند؟
یکی از تفاوتهای مهم میان هوش مصنوعی معمولی و رباتیک این است که ربات باید از «اطلاعات» به «عمل» برسد.
یک مدل زبانی ممکن است بتواند توضیح دهد که چگونه یک اتاق را مرتب کنیم.
اما ربات باید واقعاً وارد اتاق شود و این کار را انجام دهد.
این تفاوت بسیار مهم است.
یک ربات باید همزمان چند مسئله را حل کند:
-
محیط را ببیند.
-
اشیا را شناسایی کند.
-
هدف را درک کند.
-
مسیر مناسب را پیدا کند.
-
حرکت بدن خود را برنامهریزی کند.
-
با دستها اشیا را کنترل کند.
-
نتیجه کار را بررسی کند.
-
در صورت تغییر شرایط، تصمیم خود را اصلاح کند.
به همین دلیل Figure روی مفهوم Physical AI یا هوش مصنوعی فیزیکی تمرکز کرده است؛ یعنی هوش مصنوعیای که نهفقط اطلاعات را پردازش میکند، بلکه میتواند در دنیای فیزیکی عمل کند.
در چنین سیستمی، دادههای انسانی میتوانند نقش چیزی شبیه تجربه زندگی را برای ربات داشته باشند.
تنوع دادهها؛ از خانه تا کارخانه
دنیای واقعی بسیار پیچیدهتر از محیطهای آزمایشگاهی است.
یک شیء ممکن است در مکانهای مختلف قرار بگیرد. نور تغییر کند. افراد دیگری وارد محیط شوند. یک مسیر بسته شود یا جسمی که ربات انتظارش را نداشته، در مسیر قرار گیرد.
این همان جایی است که تنوع داده اهمیت پیدا میکند.
هرچه یک مدل با شرایط بیشتری مواجه شده باشد، احتمال اینکه بتواند بخشی از دانستههای خود را به محیط جدید منتقل کند بیشتر میشود.
Figure در معرفی Index تأکید کرده است که هدف این پروژه تنها افزایش تعداد نمونهها نیست؛ بلکه ایجاد مجموعهای متنوع از رفتارها، اشیا، فعالیتها و محیطهاست.
این مسئله برای رباتهای انساننما اهمیت بیشتری دارد، زیرا این رباتها قرار است در محیطهایی فعالیت کنند که اساساً برای انسانها طراحی شدهاند.
خانه، دفتر، کارخانه، فروشگاه و انبار همگی برای بدن انسان ساخته شدهاند.
بنابراین رباتی که ساختار بدنش شبیه انسان است، میتواند از تجربه انسانها بهعنوان یک منبع آموزشی مهم استفاده کند.
ویدئوی انسان چگونه به داده آموزشی ربات تبدیل میشود؟
یک ویدئوی خام بهتنهایی برای آموزش ربات کافی نیست.
اگر هزاران ساعت ویدئو بدون دستهبندی، کنترل کیفیت و پردازش در اختیار مدل قرار بگیرد، الزاماً نتیجه مطلوب به دست نمیآید.
Figure برای Index یک خط پردازش داده ایجاد کرده است تا ویدئوهای خام به داده قابل استفاده برای آموزش مدل تبدیل شوند.
این فرآیند شامل بررسی کیفیت داده، شناسایی نمونههای نامعتبر، حذف دادههای تکراری و ایجاد توضیحات ساختاریافته درباره فعالیتهای موجود در ویدئوهاست. Figure همچنین از دستهبندی معنایی برای بررسی تنوع دادهها استفاده میکند.
میتوان این فرآیند را به شکل ساده اینگونه تصور کرد:
ویدئوی خام
⬇️
بررسی کیفیت
⬇️
حذف دادههای نامعتبر و تکراری
⬇️
تشخیص فعالیت و اشیا
⬇️
توصیف و دستهبندی داده
⬇️
آمادهسازی برای آموزش مدل
⬇️
یادگیری ربات
این مرحله یکی از مهمترین بخشهای پروژه است؛ زیرا در هوش مصنوعی، کیفیت و تنوع داده به اندازه حجم داده اهمیت دارد.
[تصویر ۲ – بعد از این بخش]
پیشنهاد تصویر: نمای نزدیک و واقعگرایانه از فرآیند تبدیل ویدئوی فعالیت انسانی به داده آموزشی؛ چند ویدئوی واقعی از کارهای روزمره روی نمایشگرهای یک مرکز تحقیقاتی دیده شود و در کنار آن یک پژوهشگر دادهها را بررسی کند. بدون متن، لوگو یا رابط کاربری فانتزی.
Helix چیست و چه نقشی در این پروژه دارد؟

دادههای Index در نهایت باید به یک سیستم هوش مصنوعی منتقل شوند که بتواند از آنها برای کنترل ربات استفاده کند.
اینجاست که Helix وارد ماجرا میشود.
Figure، Helix را یک مدل Vision-Language-Action یا VLA معرفی میکند؛ مدلی که برای اتصال درک بصری، زبان و عمل طراحی شده است.
به زبان ساده، Helix باید بتواند سه نوع اطلاعات را به یکدیگر متصل کند:
آنچه ربات میبیند
آنچه انسان از ربات میخواهد
کاری که ربات باید انجام دهد
برای مثال، اگر به ربات گفته شود:
«لباسهای روی زمین را جمع کن.»
ربات باید ابتدا محیط را مشاهده کند، لباسها را تشخیص دهد، موقعیت آنها را بفهمد، مسیر مناسب را پیدا کند و سپس حرکات لازم را انجام دهد.
بنابراین Helix صرفاً یک مدل تشخیص تصویر نیست.
هدف، ایجاد سیستمی است که بتواند ادراک، تصمیمگیری و کنترل حرکت را در یک چرخه به هم متصل کند. Figure نیز Helix را سیستمی معرفی میکند که حلقه ادراک، حرکت و استدلال را بهصورت بلادرنگ کنترل میکند.
[تصویر ۳ – بعد از بخش Helix]
پیشنهاد تصویر: ربات انساننمای واقعگرای Figure در یک خانه مدرن، در حال مشاهده یک اتاق و تصمیمگیری برای انجام یک کار؛ تصویر باید مفهوم «دیدن → درک کردن → اقدام کردن» را با ترکیب بصری طبیعی نشان دهد، بدون فلش، متن، لوگو یا هولوگرامهای اغراقآمیز.
چرا آموزش ربات با آموزش یک مدل هوش مصنوعی معمولی متفاوت است؟
مدلهای هوش مصنوعی معمولی میتوانند از حجم عظیمی از متن، تصویر یا ویدئو یاد بگیرند.
اما ربات باید با قوانین دنیای فیزیکی نیز کنار بیاید.
اگر یک مدل زبانی اشتباه کند، معمولاً پیامد آن در همان محیط دیجیتال باقی میماند.
اما اگر یک ربات هنگام برداشتن یک جسم اشتباه کند، ممکن است جسم را بیندازد، به وسیله دیگری برخورد کند یا حتی برای انسان حاضر در محیط خطر ایجاد کند.
به همین دلیل آموزش ربات به دادههایی نیاز دارد که علاوه بر «معنا»، اطلاعات مربوط به حرکت، فضا، تماس، موقعیت و نتیجه عمل را نیز دربر داشته باشند.
این همان دلیلی است که Figure تلاش میکند داده انسانی را در مقیاس بسیار بزرگ جمعآوری کند.
در واقع، Index را میتوان تلاشی برای ساخت چیزی شبیه یک کتابخانه عظیم از تجربه فیزیکی انسانها دانست.
Figure از Go-Big تا Index چه مسیری را طی کرده است؟
پروژه Index یک ایده کاملاً جدا از فعالیتهای قبلی Figure نیست.
Figure پیشتر در پروژهای با نام Go-Big تلاش کرده بود از ویدئوهای اولشخص انسانها برای آموزش Helix استفاده کند.
در آن پروژه، Figure اعلام کرد که Helix توانسته است با استفاده از ویدئوی اولشخص انسانها، برخی رفتارهای مربوط به ناوبری در محیطهای واقعی را یاد بگیرد؛ حتی بدون استفاده از دادههای رباتی برای آن آموزش خاص.
این موضوع اهمیت زیادی داشت، زیرا نشان میداد تجربه انسانی میتواند تا حدی به رفتار ربات منتقل شود.
Index در واقع همین ایده را به مقیاس بسیار بزرگتری میبرد.
مسیر Figure را میتوان به شکل ساده اینگونه دید:
Go-Big
آزمایش استفاده از ویدئوی انسانی برای آموزش ربات
⬇️
Index
جمعآوری داده انسانی در مقیاس جهانی
⬇️
Helix
استفاده از داده برای ساخت مدل عمومیتر رباتیک
⬇️
Helix 2.5
آزمایش توانایی انتقال آموختهها به محیطهای جدید
این روند نشان میدهد Figure صرفاً روی ساخت سختافزار ربات تمرکز نکرده و همزمان در حال ساخت یک زیرساخت داده و هوش مصنوعی برای رباتهای خود است.
Helix 2.5؛ وقتی ربات وارد خانهای میشود که هرگز ندیده است

یکی از مهمترین اتفاقات مرتبط با پروژه Index در سپتامبر ۲۰۲۶ رخ داد.
Figure از Helix 2.5 رونمایی کرد و آن را در ۳۰ خانه در منطقه خلیج سانفرانسیسکو آزمایش کرد؛ خانههایی که ربات در زمان آموزش آنها را ندیده بود و برای آنها داده آموزشی اختصاصی جمعآوری نشده بود.
این آزمایش برای یک دلیل اهمیت دارد:
ربات قرار نبود فقط چیزی را که قبلاً دیده بود تکرار کند؛ بلکه باید آموختههای خود را به محیطهای جدید منتقل میکرد.
Figure گزارش کرده است که Helix 2.5 در این آزمایش سه نوع فعالیت را انجام داد:
-
مرتبکردن اتاق
-
تا کردن حوله
-
مرتبکردن تخت
در مجموع، مدل در ارزیابیهای انجامشده در ۳۰ خانه، نرخ موفقیت صفرشات ۵۶ درصد را ثبت کرد؛ در حالی که مدل مشابهی که بدون پیشآموزش Index آموزش داده شده بود، فقط ۹ درصد موفقیت داشت. Figure میگوید معماری، دادههای وظیفهای، تنظیمات آموزش و ارزیابی ثابت نگه داشته شدند و تفاوت اصلی در استفاده از پیشآموزش Index بود.
این نتیجه بهتنهایی به معنای حلشدن مسئله رباتهای انساننما نیست، اما نشان میدهد دادههای انسانی گسترده میتوانند در توانایی تعمیم ربات به محیطهای جدید نقش مهمی داشته باشند.
[تصویر ۴ – بخش Helix 2.5]
پیشنهاد تصویر: ربات انساننمای واقعگرایانهای که برای نخستین بار وارد یک خانه ناشناخته شده و در حال مرتبکردن اتاق است؛ خانه باید واقعی و کمی متفاوت از محیطهای آزمایشگاهی باشد، با وسایل متنوع و نور طبیعی. تمرکز تصویر روی «ربات در محیط جدید» باشد، بدون متن یا لوگو.
چرا این آزمایش مهمتر از عدد ۱۶ میلیون است؟
عدد ۱۶ میلیون ویدئو بسیار بزرگ به نظر میرسد، اما سؤال اصلی این نیست که Figure چند ویدئو دارد.
سؤال مهمتر این است:
آیا این دادهها باعث میشوند ربات در محیطی که قبلاً ندیده، بهتر عمل کند؟
آزمایش Helix 2.5 دقیقاً از همین زاویه اهمیت دارد.
اگر یک ربات فقط در همان محیطهایی که برایش داده آموزشی جمعآوری شده عملکرد خوبی داشته باشد، هنوز برای استفاده عمومی محدود خواهد بود.
اما اگر بتواند از تجربههای قبلی خود الگو استخراج کند و آن را به محیط جدید منتقل کند، مسیر رسیدن به رباتهای عمومی بسیار کوتاهتر میشود.
Figure در گزارش خود میگوید افزایش دادههای Index با بهبود عملکرد انتقال مهارت همراه بوده و این شرکت تلاش میکند رابطه میان مقیاس داده، آموزش و عملکرد ربات را بررسی کند.
در نتیجه، پروژه Index را نباید فقط یک پروژه «جمعآوری ویدئو» دانست.
هدف اصلی، ساخت تجربهای قابل انتقال برای یک ماشین است.
و این دقیقاً همان نقطهای است که هوش مصنوعی وارد دنیای فیزیکی میشود.
Figure برای داده و محاسبات چقدر سرمایهگذاری میکند؟
ساخت یک مدل هوش مصنوعی برای ربات انساننما فقط به جمعآوری داده محدود نمیشود. پس از جمعآوری داده، شرکت باید آنها را ذخیره، پردازش، دستهبندی و برای آموزش مدلهای بزرگ آماده کند.
از طرف دیگر، آموزش مدلهای رباتیک به توان محاسباتی بسیار زیادی نیاز دارد.
Figure در معرفی Index اعلام کرده بود که قصد دارد طی ۱۲ ماه آینده بیش از ۱ میلیارد دلار برای داده و محاسبات هزینه کند. این عدد نشان میدهد که از نگاه این شرکت، داده دیگر یک بخش جانبی از پروژه رباتیک نیست؛ بلکه یکی از اجزای اصلی زیرساخت توسعه ربات محسوب میشود.
در ادامه نیز Figure همکاریهای بزرگی را برای افزایش ظرفیت محاسباتی خود دنبال کرده است.
این موضوع اهمیت یک نکته را نشان میدهد:
برای ساخت رباتی که بتواند در دنیای واقعی فعالیت کند، فقط داشتن یک بدنه مکانیکی پیشرفته کافی نیست.
شرکت باید همزمان سه زیرساخت را توسعه دهد:
داده
هوش مصنوعی
محاسبات
هرکدام از این سه بخش، محدودیتهای خاص خود را دارند.
چرخه توسعه رباتهای هوشمند
| بخش | نقش |
|---|---|
| داده انسانی | فراهمکردن تجربه و نمونههای متنوع |
| مدل هوش مصنوعی | یادگیری الگوها و تصمیمگیری |
| توان محاسباتی | آموزش و اجرای مدل |
| سختافزار ربات | تبدیل تصمیم به حرکت فیزیکی |
| تجربه واقعی | تولید داده و بازخورد جدید |
این چرخه میتواند به مرور زمان یک مزیت مهم برای شرکتهایی ایجاد کند که همزمان روی تمام این بخشها سرمایهگذاری میکنند.
چرا داده میتواند به اندازه سختافزار مهم باشد؟
وقتی درباره رباتهای انساننما صحبت میکنیم، معمولاً توجه ما به ظاهر ربات، سرعت حرکت، قدرت دستها یا توانایی راهرفتن آن جلب میشود.
اما در پشت این قابلیتها، یک سؤال مهمتر وجود دارد:
ربات چقدر میداند چه کاری باید انجام دهد؟
فرض کنید دو ربات دقیقاً از نظر سختافزاری مشابه باشند.
یکی از آنها با میلیونها نمونه فعالیت انسانی آموزش دیده و دیگری داده بسیار محدودی دارد.
حتی اگر موتور، دست، دوربین و ساختار مکانیکی هر دو ربات یکسان باشد، عملکرد آنها لزوماً یکسان نخواهد بود.
این مسئله یکی از دلایلی است که باعث شده رقابت در صنعت رباتیک به سمت داده و مدلهای هوش مصنوعی نیز حرکت کند.
در این شرایط، داده میتواند شبیه یک دارایی استراتژیک باشد.
هرچه یک شرکت داده متنوعتر، باکیفیتتر و مرتبطتری در اختیار داشته باشد، امکان آموزش مدلهای توانمندتر نیز بیشتر خواهد بود؛ البته این رابطه قطعی و خطی نیست و کیفیت داده، معماری مدل، روش آموزش و توانایی سختافزار همگی در نتیجه نهایی نقش دارند.
آیا ۱۶ میلیون ویدئو یعنی Figure به «تجربه ۱۶ میلیون انسان» دست پیدا کرده است؟
نه دقیقاً.
این نکته مهمی است که در تحلیل پروژه Index نباید نادیده گرفته شود.
تعداد ویدئو با تعداد تجربههای مستقل انسانی یکسان نیست.
ممکن است چند ویدئو مربوط به یک فعالیت مشابه باشند یا چندین نمونه از یک نوع رفتار در مجموعه داده وجود داشته باشد.
ارزش واقعی مجموعه داده به عواملی مانند:
-
تنوع فعالیتها
-
تنوع محیطها
-
کیفیت ویدئو
-
تنوع اشیا
-
نحوه برچسبگذاری
-
میزان تکرار دادهها
-
کیفیت پردازش
-
و ارتباط داده با وظایف ربات
وابسته است.
به همین دلیل Figure روی پردازش و پالایش دادهها تأکید میکند.
در واقع، هدف فقط ساختن یک آرشیو عظیم از فیلمها نیست؛ هدف ساخت مجموعهای از دادههای آموزشی قابل استفاده برای مدل رباتیک است.
حریم خصوصی؛ روی دیگر جمعآوری میلیونها ویدئو
پروژهای با این ابعاد یک سؤال مهم دیگر را هم مطرح میکند:
وقتی از فعالیتهای واقعی انسانها فیلم گرفته میشود، چه اتفاقی برای اطلاعات موجود در آن ویدئوها میافتد؟
در یک محیط واقعی، دوربین ممکن است چیزهایی فراتر از فعالیت اصلی ثبت کند.
برای مثال، در یک خانه ممکن است چهره افراد، اسناد، صفحه نمایش رایانه، آدرسها یا سایر اطلاعات شخصی در پسزمینه ویدئو قرار داشته باشد.
در محیط کار نیز ممکن است اطلاعات محرمانه شرکتها یا اسناد داخلی در تصویر دیده شوند.
به همین دلیل پروژههای جمعآوری داده انسانی باید موضوعاتی مانند رضایت کاربران، نحوه استفاده از داده، نگهداری اطلاعات و حفاظت از دادههای حساس را جدی بگیرند.
از دید فنی نیز پالایش داده اهمیت دارد.
هرچه داده بزرگتر شود، مدیریت آن دشوارتر میشود و سیستم باید بتواند نمونههای نامناسب، تکراری یا حاوی اطلاعات حساس را شناسایی و مدیریت کند.
بنابراین یکی از چالشهای اصلی پروژههایی مانند Index فقط این نیست که:
«چگونه داده بیشتری جمع کنیم؟»
بلکه این سؤال هم اهمیت دارد:
«چگونه داده را به شکل مسئولانه و امن جمعآوری و استفاده کنیم؟»
این موضوع در آینده رباتیک اهمیت بیشتری پیدا خواهد کرد؛ زیرا رباتها قرار است در محیطهای بسیار شخصی مانند خانهها نیز فعالیت کنند.
[تصویر ۵ – حریم خصوصی و داده]
پیشنهاد تصویر: محیط واقعی یک خانه مدرن که یک ربات انساننما در آن حضور دارد؛ در پسزمینه دوربینها و سیستم پردازش داده بهصورت کاملاً طبیعی و غیراغراقآمیز دیده شوند و یک متخصص امنیت داده در حال بررسی اطلاعات باشد. تصویر باید مفهوم «ربات + داده انسانی + حریم خصوصی» را منتقل کند، بدون نمایش متن یا اطلاعات شخصی واقعی.
آیا رباتهای انساننما واقعاً میتوانند رفتار انسان را یاد بگیرند؟
پاسخ به این سؤال ساده نیست.
یک ربات میتواند از دادههای انسانی الگوهایی یاد بگیرد، اما این موضوع با «درک کامل انسان» تفاوت دارد.
انسان هنگام انجام یک کار، اطلاعات بسیار زیادی را بهصورت ناخودآگاه در نظر میگیرد.
برای مثال، وقتی فردی یک فنجان را از روی میز برمیدارد، ممکن است بدون فکرکردن به وزن، جنس، دما، فاصله، موقعیت انگشتان و حتی احتمال لغزش توجه کند.
برای ربات، همین فعالیت میتواند مجموعهای از مسائل جداگانه باشد.
ربات باید محیط را ببیند، اشیا را تشخیص دهد، حرکت مناسب را انتخاب کند و در لحظه واکنش نشان دهد.
به همین دلیل آموزش رباتها فقط مسئله «دیدن» نیست.
ربات باید بتواند:
ببیند → درک کند → تصمیم بگیرد → حرکت کند → نتیجه را بررسی کند
و اگر اتفاقی غیرمنتظره رخ داد، دوباره این چرخه را تکرار کند.
این همان چیزی است که توسعه مدلهای Vision-Language-Action را مهم میکند.
Figure و آینده هوش مصنوعی فیزیکی
هوش مصنوعی تا مدت زیادی عمدتاً در فضای دیجیتال فعالیت میکرد.
مدلهای زبانی متن تولید میکردند، مدلهای تصویری عکس میساختند و سیستمهای نرمافزاری دادهها را تحلیل میکردند.
اما رباتهای انساننما مسیر دیگری را دنبال میکنند.
در اینجا هوش مصنوعی باید بدن داشته باشد.
این تغییر باعث شده اصطلاحاتی مانند Embodied AI یا هوش مصنوعی تجسمیافته بیشتر مورد توجه قرار بگیرند.
در هوش مصنوعی تجسمیافته، سیستم فقط اطلاعات را پردازش نمیکند؛ بلکه از طریق یک بدن یا عامل فیزیکی با محیط تعامل دارد.
به همین دلیل دادههای واقعی اهمیت بیشتری پیدا میکنند.
یک مدل ممکن است در محیط دیجیتال درباره یک کار اطلاعات زیادی داشته باشد، اما برای انجام واقعی آن کار باید تجربه فیزیکی نیز در اختیار داشته باشد.
پروژه Index را میتوان بخشی از همین حرکت به سمت هوش مصنوعی فیزیکی دانست.
آیا رباتهای انساننما میتوانند بازار کار را تغییر دهند؟
یکی از مهمترین پرسشهایی که با توسعه رباتهای انساننما مطرح میشود، تأثیر آنها بر مشاغل است.
اگر رباتی بتواند کارهایی مانند جابهجایی کالا، مرتبکردن وسایل، فعالیت در خطوط تولید یا برخی وظایف خدماتی را انجام دهد، طبیعی است که بخشی از فعالیتهای انسانی قابل اتوماسیون شود.
اما نباید از پروژه Index نتیجه گرفت که رباتها بهزودی تمام مشاغل را جایگزین خواهند کرد.
بین «توانایی انجام یک وظیفه» و «جایگزینی کامل یک شغل» تفاوت بسیار زیادی وجود دارد.
یک شغل معمولاً مجموعهای از وظایف مختلف است.
برای مثال، یک نیروی انبار ممکن است علاوه بر جابهجایی کالا، با همکاران ارتباط برقرار کند، مشکلات غیرمنتظره را حل کند، وضعیت سفارشها را بررسی کند و تصمیمهای مختلفی بگیرد.
ممکن است یک ربات بتواند بخشی از این فعالیتها را انجام دهد، اما این به معنی جایگزینی کامل فرد نیست.
بنابراین تأثیر رباتهای انساننما بر بازار کار احتمالاً به عوامل مختلفی وابسته خواهد بود:
-
هزینه خرید و نگهداری ربات
-
میزان اطمینانپذیری
-
سرعت انجام کار
-
قوانین و استانداردهای ایمنی
-
نوع صنعت
-
هزینه نیروی انسانی
-
میزان انعطافپذیری ربات
-
و توانایی ربات در انجام وظایف متنوع
به همین دلیل، آینده بازار کار را نمیتوان تنها با تعداد رباتهای ساختهشده پیشبینی کرد.
رباتهای انساننما در چه کسبوکارهایی کاربرد خواهند داشت؟
اگر فناوری به سطح قابل اعتماد برسد، محیطهایی که دارای فعالیتهای تکراری، فیزیکی و ساختاریافته هستند میتوانند از نخستین حوزههای استفاده از رباتهای انساننما باشند.
کارخانهها
رباتها میتوانند در برخی فرآیندهای تولید، جابهجایی قطعات و وظایف تکراری مورد استفاده قرار بگیرند.
انبارها و مراکز لجستیک
جابهجایی بستهها، مرتبسازی کالا و فعالیتهای فیزیکی از حوزههایی هستند که میتوانند از اتوماسیون رباتیک بهره ببرند.
رستورانها
برخی فعالیتهای تکراری مانند جابهجایی ظروف یا آمادهسازی محیط میتوانند در آینده قابلیت خودکارسازی بیشتری داشته باشند.
فروشگاهها
رباتهای انساننما میتوانند در برخی سناریوها برای جابهجایی کالا، مرتبسازی قفسهها یا فعالیتهای پشتیبانی مورد استفاده قرار بگیرند.
خانهها
خانه احتمالاً یکی از پیچیدهترین محیطها برای رباتها خواهد بود؛ زیرا برخلاف کارخانه، هیچ دو خانهای دقیقاً شبیه یکدیگر نیستند.
همین مسئله باعث میشود آزمایش Figure در خانههای ناآشنا اهمیت بیشتری پیدا کند.
رقابت Figure فقط بر سر ساخت ربات نیست
Figure تنها شرکتی نیست که روی رباتهای انساننما سرمایهگذاری میکند.
شرکتهای مختلفی در سراسر جهان در حال توسعه رباتهایی هستند که میتوانند در محیطهای انسانی حرکت کنند و فعالیتهای مختلفی انجام دهند.
اما مسیر Figure یک ویژگی مشخص دارد:
تمرکز همزمان روی ربات، داده و مدل هوش مصنوعی.
در چنین رویکردی، ربات فقط یک محصول سختافزاری نیست.
یک اکوسیستم کامل شکل میگیرد:
ربات
⬇️
جمعآوری تجربه
⬇️
تولید داده
⬇️
آموزش مدل
⬇️
بهبود عملکرد ربات
⬇️
جمعآوری تجربه بیشتر
این چرخه میتواند با گذشت زمان ارزشمندتر شود.
هرچه رباتها در محیطهای بیشتری فعالیت کنند، دادههای بیشتری تولید میشود و این دادهها میتوانند برای بهبود مدلهای بعدی مورد استفاده قرار بگیرند.
آیا داده میتواند مزیت رقابتی اصلی رباتیک باشد؟
در سالهای آینده احتمالاً یکی از مهمترین رقابتها میان شرکتهای رباتیک، رقابت بر سر دادههای باکیفیت خواهد بود.
ساخت سختافزار پیشرفته دشوار است، اما یک شرکت میتواند با سرمایهگذاری بیشتر، مهندسان بیشتری استخدام کند و سختافزار خود را توسعه دهد.
ساخت یک مجموعه داده بزرگ و متنوع از رفتار انسانها مسئله متفاوتی است.
شرکتی که زودتر شبکه جمعآوری داده خود را ایجاد کند، میتواند به تجربه بیشتری دسترسی پیدا کند.
البته این موضوع به معنی آن نیست که هر شرکتی با داده بیشتر الزاماً ربات بهتری خواهد ساخت.
معماری مدل، کیفیت داده، سختافزار، روش آموزش، هزینه محاسبات و توانایی انتقال آموختهها به محیطهای جدید همگی اهمیت دارند.
اما Index نشان میدهد داده در حال تبدیلشدن به یکی از پایههای اصلی صنعت رباتیک است.
این اتفاق چه معنایی برای کسبوکارهای ایرانی دارد؟
شاید در نگاه اول پروژه Figure ارتباط مستقیمی با کسبوکارهای ایرانی نداشته باشد، اما روندی که پشت آن قرار دارد اهمیت زیادی دارد.
فناوری در حال حرکت از مرحلهای است که صرفاً اطلاعات را در اختیار انسان قرار میدهد، به مرحلهای که خود سیستم میتواند بخشی از کار را انجام دهد.
امروز یک کسبوکار ممکن است از:
-
وبسایت
-
اپلیکیشن
-
سیستم مدیریت مشتری
-
فروشگاه اینترنتی
-
ابزارهای هوش مصنوعی
-
اتوماسیون
-
تحلیل داده
استفاده کند.
در آینده، این زیرساختهای دیجیتال میتوانند با سیستمهای فیزیکی هوشمند نیز ارتباط بیشتری پیدا کنند.
برای مثال، یک فروشگاه آنلاین را تصور کنید که اطلاعات سفارش را به سیستم انبار ارسال میکند و یک سیستم رباتیک مسئولیت بخشی از فرآیند آمادهسازی سفارش را بر عهده میگیرد.
در چنین سناریویی، وبسایت، نرمافزار، هوش مصنوعی، داده و رباتیک دیگر فناوریهای جدا از هم نیستند؛ بلکه بخشهای مختلف یک زنجیره دیجیتال هستند.
به همین دلیل توسعه زیرساخت دیجیتال کسبوکارها میتواند در بلندمدت اهمیت بیشتری پیدا کند.
Figure چه چیزی را به ما نشان میدهد؟
شاید مهمترین پیام پروژه Index این نباشد که یک شرکت بیش از ۱۶ میلیون ویدئو جمع کرده است.
پیام بزرگتر این است که آموزش رباتها در حال تغییر است.
در گذشته، بخش بزرگی از آموزش رباتیک در محیطهای کنترلشده انجام میشد.
اما نسل جدید رباتها باید در محیط واقعی فعالیت کند؛ محیطی که دائماً تغییر میکند.
برای رسیدن به چنین هدفی، ربات به تجربه نیاز دارد.
و Figure تلاش میکند این تجربه را از رفتار میلیونها انسان استخراج کند.
اگر این مسیر موفق باشد، ممکن است در آینده رباتها بتوانند از مجموعه عظیمی از رفتارهای انسانی یاد بگیرند و بخشی از این تجربه را به محیطهایی منتقل کنند که قبلاً ندیدهاند.
این دقیقاً همان چیزی است که آزمایشهای جدید Helix به دنبال بررسی آن هستند.
آینده رباتهای انساننما؛ داده، هوش مصنوعی یا سختافزار؟
پاسخ احتمالاً «همه آنها» است.
یک ربات پیشرفته بدون هوش مصنوعی مناسب محدود خواهد بود.
یک مدل هوش مصنوعی قدرتمند بدون بدن مناسب نمیتواند در دنیای واقعی فعالیت کند.
و هر دو بدون داده کافی نمیتوانند بهدرستی آموزش ببینند.
بنابراین آینده رباتیک را میتوان به شکل یک مثلث تصور کرد:
سختافزار
بدن، دستها، دوربینها، حسگرها و سیستم حرکتی
هوش مصنوعی
درک محیط، تصمیمگیری و کنترل
داده
تجربهای که به مدل اجازه میدهد رفتارهای مختلف را یاد بگیرد
در کنار این سه مورد، یک عامل دیگر نیز اهمیت دارد:
محاسبات
هرچه مدلها بزرگتر و دادهها بیشتر شوند، توان پردازشی بیشتری برای آموزش و اجرای آنها نیاز خواهد بود.
به همین دلیل صنعت رباتیک آینده احتمالاً ترکیبی از مهندسی مکانیک، هوش مصنوعی، داده، رایانش ابری، تراشه و نرمافزار خواهد بود.
جمعبندی؛ Figure میخواهد رباتها از دنیای واقعی یاد بگیرند
پروژه Index شرکت Figure یکی از نمونههای مهمی است که نشان میدهد مسیر توسعه رباتهای انساننما در حال تغییر است.
Figure بیش از ۱۶ میلیون ویدئو از فعالیتهای انسانی جمعآوری کرده و دادههایی از ۱۰۸ کشور را وارد شبکه آموزشی خود کرده است. هدف این دادهها، کمک به توسعه مدلهای رباتیک مانند Helix و افزایش توانایی رباتها در درک و انجام فعالیتهای دنیای واقعی است.
اهمیت پروژه فقط در تعداد ویدئوها نیست.
تنوع محیطها، فعالیتها و اشیای موجود در این دادهها میتواند به مدل کمک کند تا به جای یادگیری یک دستور مشخص، الگوهای عمومیتری از رفتار فیزیکی انسانها را یاد بگیرد.
آزمایش Helix 2.5 در ۳۰ خانه ناآشنا نیز نشان داد که Figure در حال بررسی یک مسئله بسیار مهم است: آیا ربات میتواند چیزی را که در محیطهای مختلف یاد گرفته، به یک محیط کاملاً جدید منتقل کند؟
Figure گزارش کرده که پیشآموزش Index در این آزمایش با افزایش نرخ موفقیت صفرشات از ۹ درصد به ۵۶ درصد همراه بوده است.
البته این نتایج به معنای آن نیست که رباتهای انساننما اکنون قادر به انجام همه فعالیتهای انسانی هستند.
هنوز چالشهای بزرگی در زمینه ایمنی، قابلیت اطمینان، هزینه، حریم خصوصی، مصرف انرژی، کنترل حرکتی و تعمیم مهارتها وجود دارد.
اما مسیر Figure یک نکته مهم را روشن میکند:
برای ساخت رباتهای واقعاً عمومی، فقط ساختن بدن شبیه انسان کافی نیست؛ ربات باید تجربهای شبیه تجربه دنیای واقعی انسانها نیز داشته باشد.
و شاید رقابت اصلی صنعت رباتیک در سالهای آینده فقط بر سر این نباشد که چه شرکتی ربات زیباتر یا سریعتری میسازد؛ بلکه بر سر این باشد که چه کسی میتواند داده بهتر، مدل هوشمندتر و زیرساخت محاسباتی قدرتمندتری برای آموزش رباتها ایجاد کند.
سوالات متداول
پروژه Index شرکت Figure چیست؟
Index پروژه جمعآوری دادههای انسانی شرکت Figure است که با هدف ایجاد مجموعهای بزرگ از دادههای فعالیتهای واقعی انسانها برای آموزش مدلهای هوش مصنوعی رباتیک ایجاد شده است.
Figure چند ویدئو از فعالیت انسانها جمع کرده است؟
طبق اطلاعات رسمی Figure، پروژه Index بیش از ۱۶ میلیون ویدئو جمعآوری کرده است. دادهها از ۱۰۸ کشور دریافت شدهاند.
Helix چیست؟
Helix خانوادهای از مدلهای هوش مصنوعی Figure برای کنترل رباتهای انساننماست. Figure آن را در دسته مدلهای Vision-Language-Action یا VLA قرار میدهد؛ یعنی مدلی که میان دیدن، درک زبان و انجام عمل ارتباط برقرار میکند.
چرا Figure از ویدئوهای انسانها برای آموزش ربات استفاده میکند؟
زیرا ویدئوهای واقعی میتوانند نمونههای متنوعی از نحوه تعامل انسانها با اشیا و محیطهای مختلف ارائه کنند و به مدلهای رباتیک در یادگیری رفتارهای فیزیکی کمک کنند.
آیا هر ویدئو مستقیماً وارد مدل هوش مصنوعی میشود؟
خیر. دادههای خام باید پردازش، بررسی، پالایش و دستهبندی شوند تا نمونههای نامعتبر یا تکراری حذف شوند و داده برای آموزش مدل آماده شود.
Helix 2.5 چه چیزی را آزمایش کرد؟
Figure Helix 2.5 را در ۳۰ خانهای که در زمان آموزش مشاهده نشده بودند آزمایش کرد تا توانایی مدل برای تعمیم مهارتها به محیطهای جدید بررسی شود.
آیا رباتهای Figure میتوانند همه کارهای انسان را انجام دهند؟
خیر. توانایی رباتها همچنان محدود به مجموعهای از وظایف و شرایط مشخص است و فاصله زیادی میان انجام برخی فعالیتهای مشخص و توانایی عمومی انسان وجود دارد.
آیا این فناوری باعث از بین رفتن مشاغل میشود؟
ممکن است اتوماسیون رباتیک برخی وظایف فیزیکی و تکراری را تغییر دهد، اما از پروژه Index بهتنهایی نمیتوان درباره میزان یا سرعت جایگزینی مشاغل نتیجهگیری کرد. هزینه، قابلیت اطمینان، قوانین، ایمنی و شرایط اقتصادی نیز نقش مهمی دارند.
چرا داده برای رباتهای انساننما اهمیت دارد؟
زیرا ربات باید علاوه بر شناخت اشیا، نحوه تعامل با محیط فیزیکی را نیز یاد بگیرد. دادههای متنوع میتوانند نمونههای بیشتری از شرایط واقعی در اختیار مدل قرار دهند.
آیا جمعآوری میلیونها ویدئو نگرانیهای حریم خصوصی ایجاد میکند؟
بله. هر پروژهای که داده تصویری از زندگی واقعی انسانها جمعآوری میکند باید موضوعاتی مانند رضایت، امنیت داده، اطلاعات شخصی و نحوه استفاده از دادهها را مورد توجه قرار دهد.
آیا Figure تنها شرکتی است که روی رباتهای انساننما کار میکند؟
خیر. شرکتها و مجموعههای مختلفی در جهان روی رباتهای انساننما و هوش مصنوعی فیزیکی کار میکنند. Figure یکی از شرکتهایی است که همزمان روی سختافزار، مدل هوش مصنوعی و زیرساخت داده تمرکز کرده است.
آیا آینده رباتیک به داده وابسته است؟
داده یکی از عوامل مهم خواهد بود، اما تنها عامل نیست. کیفیت مدل، سختافزار، توان محاسباتی، داده، الگوریتمهای آموزشی و توانایی ربات در تعمیم مهارتها همگی در عملکرد نهایی نقش دارند.
دیدگاه خود را ثبت کنید...
آدرس ایمیل شما با توجه به قوانین حریم خصوصی منتشر نمی شود.